Aus einem einzigen Video wird ein Raum, in dem sich die Zeit zurückspulen lässt.
Visualisierung: Ein Techniker mit Kamera am Stirnband schließt eine Leitung in einem geöffneten Metallgehäuse an, Person, Gehäuse und Verkabelung sind frei gestaltet | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
Ein Techniker öffnet den Deckel eines Schaltgehäuses, steckt ein Kabel in eine Klemme und schließt den Deckel wieder. Am Kopf trägt er eine Kamera, die alles aus seiner Perspektive filmt. Ein Foto vom Endzustand zeigt später nur ein geschlossenes Gehäuse. Das Video zeigt mehr, aber jede Bewegung nur aus dem einen Blickwinkel, den der Techniker gerade hatte.
Genau hier setzt eine Forschungsarbeit an, die am 11. November 2026 auf der Preprint-Plattform arXiv erschienen ist. Leonardo Vanni, Stefano Gasperini, Federico Tombari und Chiara Plizzari beschreiben ein Verfahren, das aus einem einzigen solchen Video ein dreidimensionales Modell berechnet, in dem sich nicht nur der Raum, sondern auch die Veränderung der Objekte nachvollziehen lässt: das Öffnen, Verbinden, Teilen und Schließen.[1] Fachleute sprechen von 4D, drei Raumdimensionen plus Zeit. Die Arbeit ist ein Preprint und wurde noch nicht von unabhängigen Fachgutachtern geprüft.
Dieser Beitrag begleitet das Gehäuse-Beispiel durch den gesamten Prozess, in acht Phasen vom Rohvideo bis zum Ergebnis. Das Beispiel ist erdacht, es passt zu den Ereignistypen des Papers. Jede Phase baut auf der vorherigen auf und erklärt, was dort geschieht, warum es schwierig ist und welche Zahlen das Paper dazu nennt. Am Ende steht die Frage, was Unternehmen mit einer solchen Technik anfangen können und woran sich ihr Nutzen messen lässt.
- Ein Video aus der Ich-Perspektive ist der einzige Rohstoff des Verfahrens.
- Das Ergebnis ist ein 3D-Modell, das sich über die Zeit verändert, kurz 4D.
- Im Fokus stehen Ereignisse, bei denen sich Teile trennen, verbinden, öffnen oder schließen.
- Der Prozess gliedert sich in acht aufeinander aufbauende Phasen.
- Die Forschungsarbeit ist ein Preprint ohne abgeschlossene Begutachtung.[1]
Die erste Phase beginnt dort, wo jeder Prozess beginnt, bei der Aufnahme.
Aufnehmen, was ein Mensch wirklich sieht
Phase 1 von 8 · Aufnehmen
Alles beginnt mit dem Rohmaterial. Egozentrisches Video, also Video aus der Ich-Perspektive, entsteht mit einer am Kopf getragenen Kamera und folgt dem Blick des Menschen. Für die Forschung ist das eine reiche Quelle: Der Datensatz Ego4D umfasst 3.670 Stunden Alltagsvideo von 931 Kameraträgern an 74 Orten in neun Ländern, der größte Teil ohne Drehbuch.[2] Sein Name verbindet Ego, die Ich-Perspektive, mit 4D, drei Raumdimensionen plus Zeit.[2] Ein zweiter Datensatz, EPIC-KITCHENS, versammelt in seiner ursprünglichen Fassung 55 Stunden Küchenalltag von 32 Teilnehmenden, aufgenommen in deren eigenen Küchen.[3] Aus beiden Sammlungen wählt das Paper später die Videos für seinen Testdatensatz aus.[1]
Für die Rekonstruktion ist diese Perspektive zugleich ein Problem. Im Gehäuse-Beispiel gibt es nur eine Kamera, ein sogenanntes monokulares Video. Sie bewegt sich mit dem Kopf, die eigenen Hände verdecken die Sicht, und was im Inneren des Gehäuses liegt, sieht sie erst, wenn der Deckel offen ist. Eine Übersichtsarbeit zur 4D-Rekonstruktion nennt Selbstverdeckung und das begrenzte Sichtfeld kopfgetragener Kameras ausdrücklich als Hürden.[4]
Die Frage lautet deshalb nicht nur, was die Kamera sieht, sondern auch, wo sie dabei stand.

Eine einzelne Kamera am Kopf sieht viel, aber nie alles.
Bild: Phase 1 des Prozesses, Aufnahme aus der Ich-Perspektive an einem Schaltschrank[2][3] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Egozentrisches Video entsteht mit einer am Kopf getragenen Kamera.[2]
- Ego4D umfasst 3.670 Stunden Video von 931 Kameraträgern.[2]
- Die Testvideos des Papers stammen aus Ego4D und EPIC-KITCHENS.[1][3]
- Eine einzelne Kamera liefert zur selben Zeit nur einen Blickwinkel.
- Selbstverdeckung und ein enges Sichtfeld erschweren die Rekonstruktion.[4]
Wo die Kamera in jedem Moment stand, klärt die nächste Phase.
Vermessen, wo die Kamera stand
Phase 2 von 8 · Vermessen
Aus Pixeln wird erst dann Raum, wenn bekannt ist, von wo aus sie aufgenommen wurden. Die zweite Phase bestimmt deshalb für jedes Bild die Position und Blickrichtung der Kamera, die sogenannte Kamerapose. Das Verfahren dahinter heißt Structure from Motion, auf Deutsch etwa Struktur aus Bewegung. Es sucht in Bildern aus verschiedenen Blickwinkeln dieselben Merkmale, etwa die Ecke einer Klemme, und berechnet aus ihren Verschiebungen sowohl die Lage der Kamera als auch die Lage der Punkte im Raum.[5] Weit verbreitet ist dafür die frei verfügbare Software COLMAP.[5]
Das Ergebnis ist eine dünne Punktwolke, die nur verlässliche Merkmale enthält und keine geschlossenen Flächen, dazu eine Kameraspur, die dem Kopf des Technikers durch den Raum folgt. Das Paper setzt diese Vorarbeit voraus. Zu den Eingaben zählen das Video, kalibrierte Kameras, also Kameras mit bekannten Linsenkennwerten, Masken für Hände und Objekte sowie eine Beschreibung der Ereignisse.[1] Der Testdatensatz liefert Kamerapositionen, Kameraparameter, Masken und Auswertungsskripte gleich mit, COLMAP kommt dem Paper zufolge ebenfalls zum Einsatz.[1] Die Punktwolke wird später zum Startpunkt der eigentlichen Rekonstruktion.
Ein Haken bleibt: Structure from Motion setzt voraus, dass die Welt stillhält. Bewegt sich ein Objekt zwischen zwei Aufnahmen, verwechselt das Verfahren Objektbewegung mit Kamerabewegung. Mit dem Gehäuse in der Hand des Technikers geschieht genau das. Bevor die Rekonstruktion beginnen kann, muss deshalb getrennt werden, was ruht und was sich bewegt.
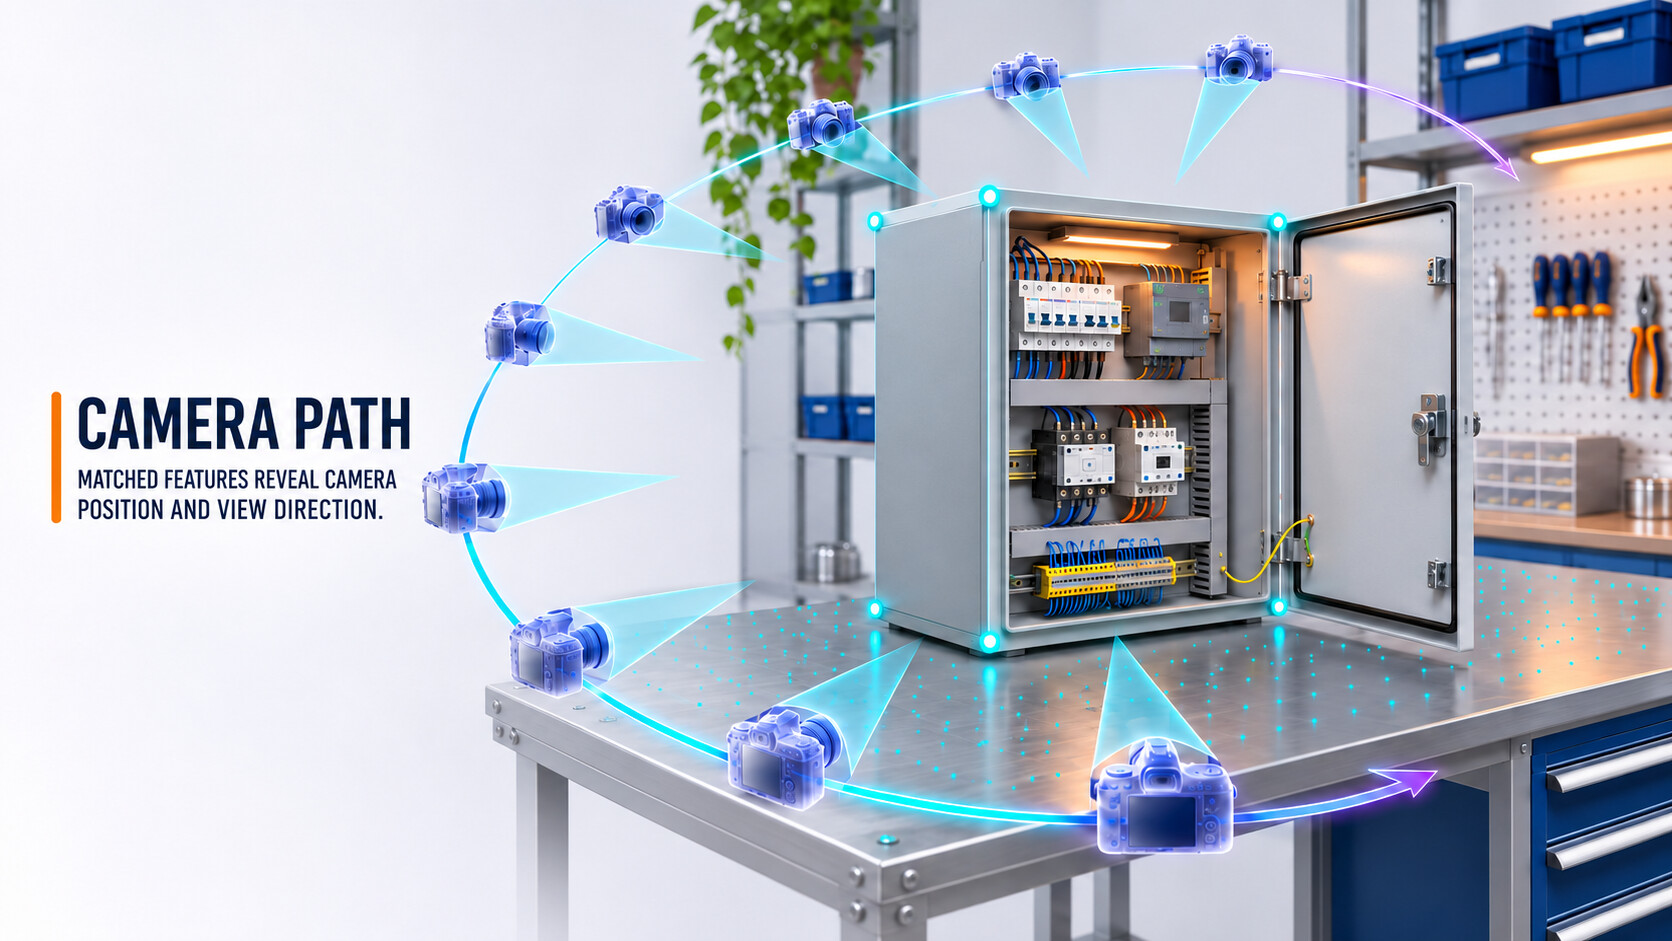
Aus Merkmalen in vielen Bildern wird der Weg der Kamera durch den Raum.
Bild: Phase 2 des Prozesses, Kamerapfad um einen Schaltschrank und dünne Punktwolke[1][5] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Jedes Bild braucht eine bekannte Kameraposition aus Ort und Blickrichtung.
- Structure from Motion berechnet sie aus Merkmalen, die in mehreren Bildern wiederkehren.[5]
- COLMAP ist eine frei verfügbare, weit verbreitete Software für diesen Schritt.[5]
- Die Eingaben des Papers umfassen Video, kalibrierte Kameras, Masken und Ereignisangaben.[1]
- Bewegte Objekte stören die Vermessung und müssen vorher getrennt werden.
Wie diese Trennung gelingt, zeigt Phase drei.
Trennen, was ruht und was sich bewegt
Phase 3 von 8 · Trennen
Im Gehäuse-Beispiel gibt es drei Rollen im Bild: den Tisch und den Raum, die stillstehen, das Gehäuse, das sich bewegt, und die Hände, die es bewegen. Die dritte Phase ordnet jedem Bildbereich eine dieser Rollen zu. Dafür entsteht pro Bild eine Maske, eine Art Schablone, die markiert, wo im Bild ein Objekt liegt. Das Paper erzeugt Objekt- und Handmasken mit SAM 3, einem im November 2025 veröffentlichten Modell von Meta, das Objekte in Bildern und kurzen Videos anhand eines Textbegriffs oder eines Beispielbilds findet, abgrenzt und über die Zeit verfolgt.[6] Alle erzeugten Masken wurden anschließend von Hand kontrolliert.[1]
Die zweite Idee dieser Phase stammt aus einem Vorgängerverfahren, auf dem das Paper aufbaut. EgoGaussian, entwickelt an der ETH Zürich, teilt ein Video in ruhige und bewegte Abschnitte. Aus den ruhigen Abschnitten entsteht der Hintergrund, und die Form des Objekts wird vorbereitet. In den bewegten Abschnitten wird das Objekt verfeinert und seine Bewegung verfolgt.[7] Die Hände werden dabei nicht mitrekonstruiert. Damit der Vergleich fair bleibt, wendet das Paper diese Ausblendung auch bei den Konkurrenzverfahren an.[1]
EgoGaussian trifft allerdings eine Annahme, die für das Gehäuse zum Problem wird: Es verfolgt starre Objekte, die sich als Ganzes bewegen und weder verformen noch in Teile zerfallen.[7] Ein Deckel, der sich vom Gehäuse löst, passt nicht in dieses Bild.

Erst wenn Hintergrund, Objekt und Hände getrennt sind, lässt sich jedes für sich rekonstruieren.
Bild: Phase 3 des Prozesses, bewegtes Gehäuse vor ruhigem Hintergrund und Zeitstrahl aus ruhigen und bewegten Abschnitten[1][6][7] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Masken markieren pro Bild, wo Hände, Objekt und Hintergrund liegen.
- SAM 3 findet und verfolgt Objekte anhand eines Textbegriffs oder Beispielbilds.[6]
- Die Masken des Papers wurden von Hand kontrolliert.[1]
- EgoGaussian teilt das Video in ruhige und bewegte Abschnitte.[7]
- Das Vorgängerverfahren verfolgt nur starre Objekte, die nicht in Teile zerfallen.[7]
Was mit diesen getrennten Teilen geschieht, hängt davon ab, wie ein Raum im Rechner überhaupt dargestellt wird. Das erklärt Phase vier.
Bauen, wie aus Farbtupfern ein Raum wird
Phase 4 von 8 · Bauen
Die vierte Phase baut das eigentliche Modell. Gaussian Splatting, 2023 von einem Team um Bernhard Kerbl vorgestellt, stellt eine Szene aus sehr vielen kleinen, halbtransparenten Ellipsoiden dar, die Gauß-Splats heißen. Jeder Splat hat eine Position, eine Form, eine Transparenz und eine Farbe.[8] Ausgangspunkt ist die dünne Punktwolke aus der Vermessung.[8] Zum Bild wird das Ganze, indem alle Splats, die ein Pixel überdecken, nach Tiefe sortiert und überblendet werden. Das gelingt so schnell, dass sich Szenen mit mindestens 30 Bildern pro Sekunde in Full-HD-Auflösung darstellen lassen.[8]
Gelernt wird im Wechselspiel: Das System rendert ein Bild, vergleicht es mit dem echten Videobild und korrigiert Position, Form und Farbe der Splats. Wo das Bild noch nicht passt, fügt es Splats hinzu oder entfernt welche.[8] Am Ende steht ein Modell, das sich aus beliebigen Blickwinkeln betrachten lässt, nicht nur aus dem der Kamera.
Ein Splat-Modell ist zunächst allerdings ein Standbild. Für bewegte Szenen entstand 4D Gaussian Splatting. Das Verfahren von Guanjun Wu und Kollegen behält einen einzigen Satz Splats und lernt ein kleines neuronales Netz, das für jeden Zeitpunkt vorgibt, wohin sich die Splats verschieben und wie sie sich verformen.[9] Auf synthetischen Testdaten rendert es bis zu 82 Bilder pro Sekunde bei 800 mal 800 Pixeln.[9] Das ist elegant, solange sich dieselben Dinge nur bewegen. Der Satz Splats ist fest, es kommen keine neuen hinzu, und keine verschwinden.

Ein Gauß-Splat ist klein, aber viele davon formen einen Raum, der sich frei betrachten lässt.
Bild: Phase 4 des Prozesses, ein Schaltschrank als Modell aus Gauß-Splats, vom groben zum verfeinerten Zustand[8][9] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Eine Szene besteht aus vielen Gauß-Splats mit Position, Form, Transparenz und Farbe.[8]
- Das Modell lernt, indem es gerenderte Bilder mit echten Videobildern vergleicht.[8]
- Die Darstellung gelingt in Echtzeit, mit mindestens 30 Bildern pro Sekunde in Full HD.[8]
- 4D Gaussian Splatting bewegt einen festen Satz Splats durch die Zeit.[9]
- Neue Flächen können in diesem Ansatz nicht entstehen, weil keine Splats hinzukommen.
Genau diese Festlegung wird beim Öffnen eines Deckels zum Problem. Phase fünf zeigt, wo das Konzept bricht.
Wenn ein Objekt sich teilt, verbindet, öffnet oder schließt
Phase 5 von 8 · Bruch
Im Gehäuse-Beispiel geschieht jetzt, woran 4D-Verfahren scheitern. Der Deckel öffnet sich, der Innenraum wird sichtbar. Das Kabel verbindet zwei vorher getrennte Teile. Der Deckel schließt sich, der Innenraum verschwindet. Das Paper nennt solche Vorgänge topologische Ereignisse: zeitlich begrenzte Handlungen, die verändern, wie Teile eines Objekts zusammenhängen, wie sie sich bewegen oder welche Flächen sichtbar sind.[1] Es unterscheidet vier Familien. Bei der Fission teilt sich ein Objekt, etwa beim Schneiden. Bei der Fusion verbinden sich Teile, zum Beispiel durch Anstecken, Anschrauben oder Verknoten. Beim Öffnen werden Flächen freigelegt, etwa durch Aufmachen oder Aufdecken. Beim Schließen verschwinden sie wieder, etwa durch Zumachen oder Abdecken.[1] Das Bild zeigt die vier Familien am Gehäuse in dieser Reihenfolge: abgehobener Deckel, angeschlossene Kabel, geöffnete Tür und wieder geschlossenes Gehäuse.
Für ein Modell mit festem Satz Splats sind solche Ereignisse eine Zumutung. Weil das Verfahren nur verformt, was schon da ist, entstehen bei Ereignissen, die Flächen teilen, verbinden oder freilegen, schwere Bildfehler.[1] Für den Gehäuseinnenraum gibt es schlicht keine Splats, die dorthin wandern könnten. Die Übersichtsarbeit zur 4D-Rekonstruktion zählt topologische Änderungen wie das Teilen und Zusammenfügen von Objekten zu den dynamischen Phänomenen, die weitgehend ungelöst sind.[4]
Bevor sich das ändern lässt, muss das Verfahren wissen, was überhaupt passiert. Topo-4DGS, kurz für topologiebewusstes 4D Gaussian Splatting, bekommt dafür eine Ereignisangabe: die Ereignisfamilie, die Zahl der entstehenden Endstücke, die Eltern-Kind-Struktur der Teile als eine Art Stammbaum und den Zeitpunkt, ab dem sich die Teile unabhängig bewegen dürfen.[1]

Vier Ereignisfamilien verändern, welche Flächen ein Objekt hat, und damit den Kern des Modells.
Bild: Phase 5 des Prozesses, die vier Ereignisfamilien Fission, Fusion, Öffnen und Schließen am Beispielgehäuse[1][4] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Topologische Ereignisse verändern Zusammenhang, Bewegung oder sichtbare Flächen eines Objekts.[1]
- Das Paper unterscheidet Fission, Fusion, Öffnen und Schließen.[1]
- Verfahren mit festem Satz Splats erzeugen bei solchen Ereignissen schwere Bildfehler.[1]
- Topologische Änderungen gelten in der Übersichtsarbeit als weitgehend ungelöst.[4]
- Topo-4DGS braucht Ereignisfamilie, Endstücke, Stammbaum der Teile und Ereigniszeitpunkt als Angabe.[1]
Wie Topo-4DGS mit diesen Angaben arbeitet, ist das Thema der sechsten Phase.
Verzweigen, wie ein Objekt in Teile zerfällt
Phase 6 von 8 · Verzweigen
Die sechste Phase ist das Herzstück des Papers. Topo-4DGS löst das Problem in zwei Schritten, die zusammen die Teile bewegen und die Flächen anpassen.[1] Der erste Schritt heißt Motion Bifurcation, auf Deutsch Bewegungsverzweigung. Bis zum Ereigniszeitpunkt bewegt sich das Objekt als ein starres Ganzes. Ab dem Ereignis verzweigt sich diese eine Bewegung in mehrere Äste, die jeweils eine eigene starre Bewegung haben.[1] Im Beispiel wandert das Gehäuse in der einen Hand, der Deckel folgt einer anderen Bahn. Dazu wird jeder Splat einem Ast zugeordnet.[1]
Der zweite Schritt, Topological Boundary Resolution, sinngemäß die Auflösung der Grenzflächen, passt an, welche Flächen es gibt. Wird das Gehäuse geöffnet, entstehen neue, bisher verdeckte Flächen. Dafür werden Splats angelegt, die genau zum Ereigniszeitpunkt aktiv werden. Wird es geschlossen, verschwinden Flächen aus der Sicht, und die zugehörigen Splats werden abgeschaltet.[1] Bei Fission und Öffnen kommen also Flächen hinzu, bei Fusion und Schließen werden sie zurückgezogen.[1] Das Paper beschreibt dafür zwei Bausteine: den Aufbau der Grenzflächen je Teil und die zeitliche Aktivierung der Splats.[1]
Die Ablationsversuche, bei denen Bausteine verändert oder weggelassen werden, zeigen, wie viel an den Vorgaben hängt. Darf die Zuordnung der Teile von Bild zu Bild beliebig wechseln, sinkt die Qualität der Nach-Ereignis-Bilder um mehr als 7 Dezibel.[1] Wird der Ereigniszeitpunkt um 16 Bilder zu früh angesetzt, fällt die Qualität des Objekts um 0,47 Dezibel, bei 16 Bildern zu spät um 1,26.[1] Die größten Gewinne erzielt das Verfahren bei Trennungsereignissen, also beim Öffnen und bei der Fission.[1] Eine Grenze setzt die Annahme starrer Teile: Topo-4DGS zielt auf zeitlich begrenzte Änderungen, deren entstehende Teile sich als starr annähern lassen.[1]

Zwei Mechanismen arbeiten zusammen: Die Bewegung verzweigt, und die Flächen werden zu- oder abgeschaltet.
Bild: Phase 6 des Prozesses, Bewegungsverzweigung (oben) und zeitliche Aktivierung der freigelegten Innenfläche (unten) in Topo-4DGS[1] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Die Bewegungsverzweigung teilt eine starre Bewegung ab dem Ereignis in mehrere Äste.[1]
- Die Grenzflächen-Auflösung aktiviert neue und deaktiviert verdeckte Flächen.[1]
- Beliebig wechselnde Teilzuordnung kostet über 7 Dezibel bei den Nach-Ereignis-Bildern.[1]
- Ein um 16 Bilder verschobener Ereigniszeitpunkt senkt die Qualität um 0,47 bis 1,26 Dezibel.[1]
- Das Verfahren setzt Teile voraus, die sich als starr annähern lassen.[1]
Ob das Verfahren tatsächlich besser funktioniert als bisherige Ansätze, prüft die siebte Phase.
Prüfen, wie gut gut ist
Phase 7 von 8 · Prüfen
Ein Verfahren ist nur so aussagekräftig wie sein Test. Für das Paper gab es keinen passenden: Kein Benchmark prüfte systematisch Fission, Fusion, Öffnen und Schließen in Egovideos.[1] Die Autoren bauten deshalb TopoEgo. Der Datensatz enthält 24 Sequenzen aus EPIC-KITCHENS und Ego4D, je zwölf aus jeder Quelle, mit 36 bewegten Objekten, 34 markierten Ereignissen und rund 4.600 Einzelbildern. Pro Ereignisfamilie und Quelle wurden drei Clips ausgewählt. Die Ereignisse wurden von Hand annotiert und geprüft, dazu kommen Kamerapositionen, Masken und Auswertungsskripte.[1]
Gemessen wird, indem das System Bilder rendert, die es im Training nicht gesehen hat, und sie mit dem echten Video vergleicht. Vier Maße beschreiben den Abstand, die Tabelle zeigt sie zusammen mit dem Vorsprung von Topo-4DGS gegenüber EgoGaussian auf den bewegten Objekten über alle 24 Clips.[1][10]
| Maß | Was es misst | Besser ist | Differenz zu EgoGaussian |
|---|---|---|---|
| PSNR | Pixelfehler zum echten Bild, in Dezibel | höher | +3,19 dB |
| SSIM | Ähnlichkeit von Helligkeit, Kontrast und Struktur | höher | +0,094 |
| LPIPS | Wahrnehmungsähnlichkeit, berechnet mit einem neuronalen Netz | niedriger | −0,036 |
| α-IoU | Deckung der Objektumrisse | höher | +0,110 |
Alle vier Maße sprechen auf den bewegten Objekten für Topo-4DGS.
Tabelle: Bewertungsmaße und Ergebnisse von Topo-4DGS gegenüber EgoGaussian auf 24 TopoEgo-Clips, bewegte Objekte[1][10] | XR Stager Online Magazin | VISORIC GmbH
Zur Einordnung hilft eine Rechenregel. Bei PSNR bedeuten rund 3 Dezibel, dass sich der mittlere quadratische Pixelfehler halbiert.[11] Auf den Bildern nach dem Ereignis liegt der Vorsprung bei 4,47 Dezibel, was rechnerisch grob dem Faktor 2,8 beim Fehler entspricht.[1][11] Die absoluten Werte relativieren das: Über alle Clips erreicht Topo-4DGS in der Objektregion 21,74 Dezibel.[1] Nach gängiger Faustregel bleiben Abweichungen im Bereich von 20 bis 30 Dezibel sichtbar.[11] Das Modell ist besser als seine Vorgänger, aber noch kein Abbild.
Vier Vorbehalte gehören dazu. Erstens liegt auf der gesamten Szene, also mit Hintergrund, ein Konkurrent vorn: Def-3DGS erreicht dort die besten Mittelwerte bei PSNR, SSIM und LPIPS, und DeGauss hat einen niedrigeren LPIPS als Topo-4DGS.[1] Der Vorteil gilt den bewegten Objekten. Zweitens braucht ein Clip im Median 10,9 Stunden auf einer A100-Grafikkarte, bei einer Spanne von 3,6 bis 22,8 Stunden, etwa das 1,28-Fache von EgoGaussian.[1] Drittens können sich Rangfolgen verschieben: Eine unabhängige Nachprüfung von 2026 kam bei EgoGaussian und dessen Vergleichsverfahren zu anderen Ergebnissen als die Originalarbeit.[12] Viertens ist die Arbeit ein Preprint, Code und Daten sind angekündigt.[1]

Scharfe Kanten und stimmige Details entscheiden, ob ein Modell verlässlich wirkt.
Bild: Phase 7 des Prozesses, unscharfes Modell links gegen scharfes Ergebnis rechts, Detailvergleich an einer Deckelkante[1][10] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- TopoEgo umfasst 24 Sequenzen, 36 bewegte Objekte und 34 markierte Ereignisse.[1]
- Auf bewegten Objekten liegt Topo-4DGS bei allen vier Maßen vor EgoGaussian.[1]
- Auf den Bildern nach dem Ereignis liegt der PSNR-Vorsprung bei 4,47 Dezibel.[1]
- Auf der Gesamtszene liegt Def-3DGS bei den Mittelwerten vorn.[1]
- Die Rechenzeit liegt im Median bei 10,9 Stunden pro Clip.[1]
Was sich aus diesen Zahlen für die Praxis ableiten lässt, führt die letzte Phase zusammen.
Nutzen, wo ein 4D-Modell der Praxis helfen könnte
Phase 8 von 8 · Nutzen
Die letzte Phase fragt nach dem Wert. Das Paper selbst nennt als Motivation Embodied AI, also KI, die in der physischen Welt handelt.[1] Für Unternehmen liegen andere Anwendungen näher. Eine Veröffentlichung von 2026 aus dem Fraunhofer-Publikationsverzeichnis beschreibt, dass Montage- und Demontageprozesse auf Expertenwissen beruhen, das sich schwer dokumentieren, wiederverwenden und weitergeben lässt. Videobasierte Darstellungen erfassen demnach Ablauf und Ausführungskontext besser als statische Bilder, genannt werden Reparatur, Schulung und Kreislaufwirtschaft.[13] Ein 4D-Modell würde das Gehäuse-Beispiel nicht als Film konservieren, sondern als Raum: anhalten, drehen, hineinschauen, den kritischen Moment aus dem besten Winkel prüfen. Das ist eine redaktionelle Einordnung. Ein Nutzen für die Schulung ist in den hier geprüften Quellen nicht belegt.
Drei Dinge stehen dem Einsatz noch im Weg. Das erste sind die Ereignisangaben. Ein automatisches Modul, das sie aus dem Video schätzt, nannte bei 26 von 36 Objekten die richtige Teilezahl, das sind 72,2 Prozent, und bei 16 von 24 Objekten die richtige Ereignisfamilie, das sind 66,7 Prozent. Es arbeitet mit einem Bildsprachmodell, das zwölf Bilder des maskierten Objekts betrachtet, und ist ein eigenständiges Vorverarbeitungswerkzeug, kein Bestandteil von Topo-4DGS. Die Benchmark-Ergebnisse beruhen auf von Hand geprüften Angaben.[1] Das zweite ist die Annahme starrer Teile, weiche, flüssige oder elastische Dinge liegen außerhalb.[1] Das dritte sind Zeit und Verfügbarkeit: gut zehn Stunden Rechenzeit pro Clip, dazu Code und Daten, die zwar angekündigt, aber noch nicht veröffentlicht sind.[1]
Wie sich ein Nutzen prüfen lässt, ist damit die eigentliche Frage. Ein 4D-Modell kann überzeugend aussehen, ohne dass jemand daraus lernt, denn PSNR misst die Ähnlichkeit zum Bild, nicht das Verständnis einer Aufgabe. Ein belastbarer Test fragt nach dem Lernergebnis: Führt eine Schulung mit dem Modell zu weniger Ausführungsfehlern, zu kürzerer Bearbeitungszeit, zu besserem Behalten nach einigen Wochen? Wie sich Verfahrensfehler erfassen lassen, zeigt der Datensatz IndustReal mit 84 Videos und 38 Ausführungsfehlern bei Montage und Wartung eines Spielzeugautos.[14] Eine plausible erste Prüfung wäre klein: ein Ablauf, eine Rekonstruktion, ein Vergleich mit einer Gruppe, die konventionell lernt.
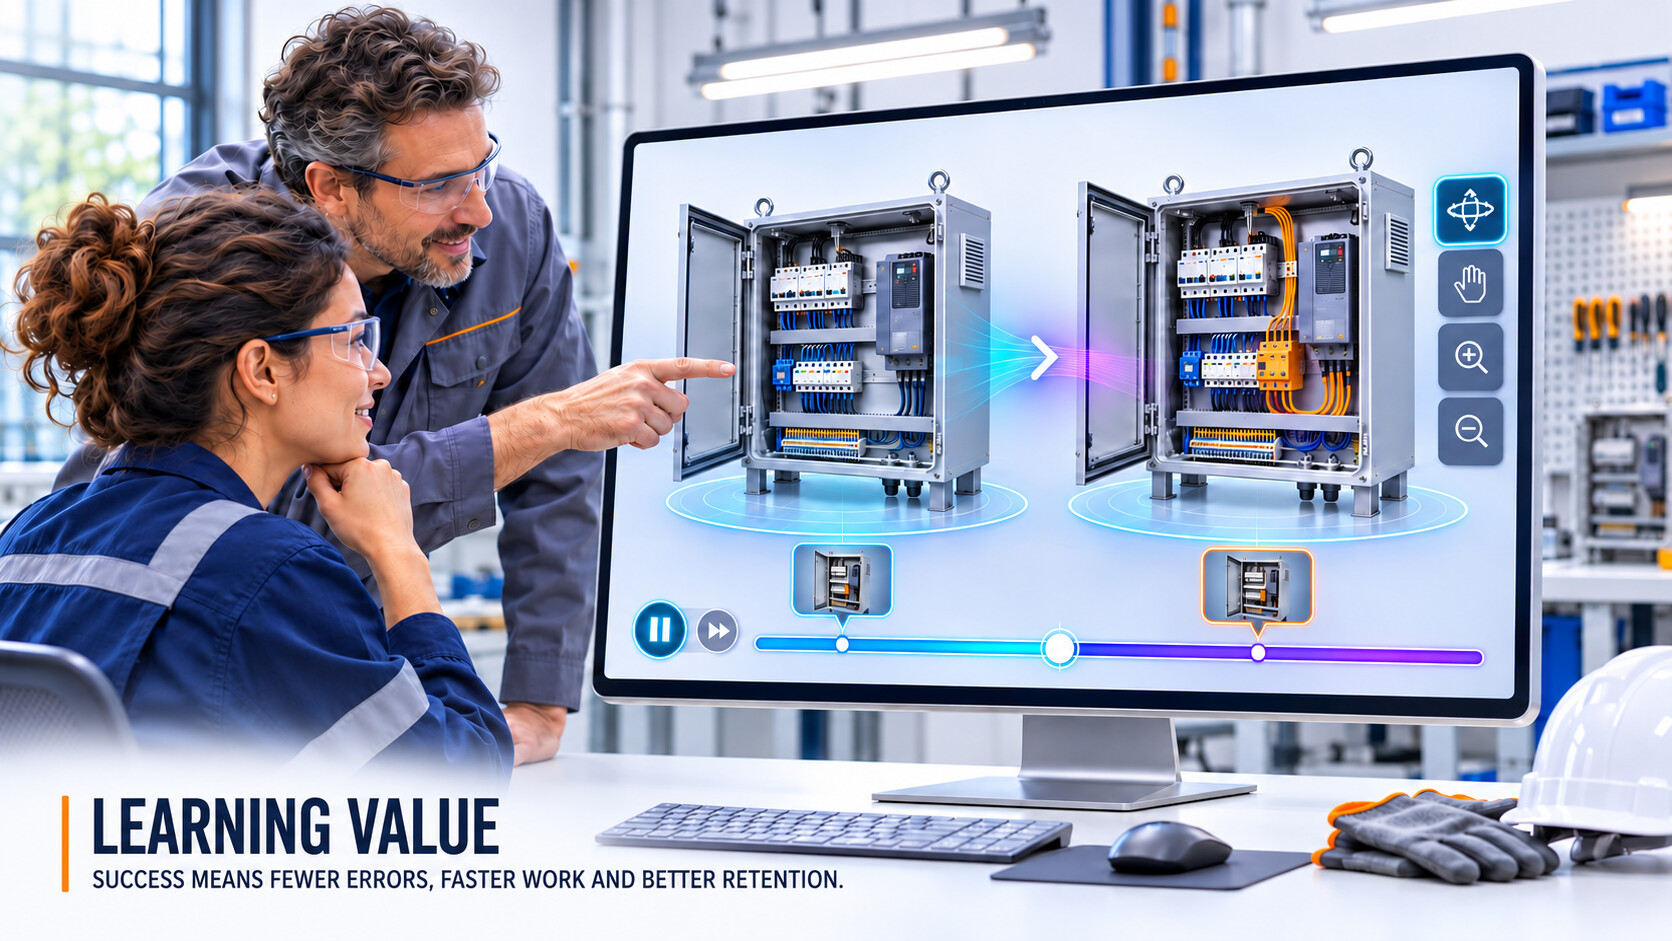
Der Wert eines 4D-Modells zeigt sich nicht am Bild, sondern am Lernerfolg danach.
Bild: Phase 8 des Prozesses, ein 4D-Modell als Lernhilfe in Montage, Wartung und Schulung[13][14] | KI-gestützte Illustration, kein Produktfoto | XR Stager Online Magazin | VISORIC GmbH
- Montage, Wartung und Schulung gelten als naheliegende Anwendungsfelder.[13]
- Ein Nutzen für die Schulung ist in den geprüften Quellen bislang nicht belegt.
- Die automatische Ereignisschätzung traf in 72,2 und 66,7 Prozent der Fälle.[1]
- Messgrößen für einen Test sind Fehlerrate, Bearbeitungszeit und Behalten nach Wochen.
- Ein kleiner erster Vergleich mit einer konventionell lernenden Gruppe ist der sinnvolle Anfang.
Wie das Prinzip in Bewegung aussieht, zeigt das folgende Video.
Das Prinzip in 41 Sekunden
Die vorangegangenen Phasen haben erklärt, wie aus einem Video ein Modell wird, das sich über die Zeit verändert. Das folgende Video bringt dieselbe Idee in Bildern: Ein Objekt wird bearbeitet, und die Rekonstruktion folgt der Veränderung. Der Film ist eine Erklärung des Autors, keine Aufnahme aus dem Paper. Die Bilder sind KI-generiert und zeigen das Prinzip, keine Messergebnisse. Die Zahlen und Ergebnisse stehen im Paper.[1]
Video: Erklärfilm zum Paper Topology-Aware 4D Gaussian Splatting for Egocentric Videos | Filmkonzept, Recherche, Analyse und Sprecher: Ulrich Buckenlei | Illustrative Bilder: KI-generiert | Forschung: Vanni et al.[1] | XR Stager Online Magazin | VISORIC GmbH
- Das Video erklärt die Kernidee des Papers in 41 Sekunden.
- Es zeigt, wie aus einer Videoaufnahme ein Modell mit Zeitverlauf entsteht.
- Die Bilder sind KI-generiert und rein illustrativ.
- Konzept, Recherche, Analyse und Sprecher stammen von Ulrich Buckenlei.
- Die zugrunde liegende Forschung stammt von Vanni et al.[1]
Zwischen einer Forschungsdemo und einer belastbaren Lernumgebung liegt ein Prüfweg, und der beginnt mit einem klar abgegrenzten ersten Schritt.
Von der Rekonstruktion zur belastbaren Lernumgebung
In jedem Betrieb gibt es einen Handgriff, den nur wenige Fachkräfte wirklich beherrschen: eine Wartung, eine Montage, eine Inbetriebnahme. Heute existiert er vielleicht als Video, das jeder nur aus dem einen Blickwinkel der Kamera sieht. Als Raum und Zeitverlauf ließe er sich von allen Seiten betrachten, anhalten und zurückspulen. Aus einer eindrucksvollen Rekonstruktion wird dabei erst dann eine Schulung, wenn drei Dinge zusammenkommen: ein Verfahren, das sich prüfen lässt, ein Modell, das sich in bestehende Systeme einfügen lässt, und ein Test, der Lernerfolg und Fehlerrate misst.
Das Expertenteam der VISORIC GmbH aus München verbindet über 15 Jahre Erfahrung in 3D, KI und XR mit praktischer Erfahrung in Spatial Computing, Echtzeit-3D und Digitalen Zwillingen. VISORIC ordnet neue Verfahren wie Gaussian Splatting ein, prüft, was davon für Training und digitale Zwillinge trägt, und begleitet Unternehmen von der ersten Idee bis zur einsatzfähigen Anwendung. Gemeinsam mit Ihnen klärt das Team, welcher Handgriff sich für den Einstieg eignet, bereitet ihn auf und misst, was Ihre Mitarbeitenden daraus lernen.[15][16]
15 Jahre Erfahrung in 3D, KI und XR: das VISORIC Expertenteam aus München.
Bild: © Ulrich Buckenlei | XR Stager Online Magazin | VISORIC GmbH
Ein durchdachtes Pilotprojekt mit einem einzelnen Ablauf und einer klar abgegrenzten Lernumgebung lässt sich oft deutlich schneller und kostengünstiger realisieren, als viele Unternehmen erwarten. Der Einstieg besteht aus drei Schritten:
- Auswahl eines Ablaufs für den ersten Versuch, etwa eine Wartung, Montage oder Inbetriebnahme.
- Aufbereitung als digitaler Zwilling oder XR-Training, in dem sich der Ablauf anhalten, drehen und wiederholen lässt.
- Messung von Fehlerrate, Bearbeitungszeit und Behalten, bevor über eine Ausweitung entschieden wird.
Genau darin liegt der Ausgangspunkt für ein Gespräch: nicht bei der großen, unternehmensweiten Vision, sondern bei einem klar abgegrenzten, schnell umsetzbaren ersten Schritt.
Welcher Ablauf in Ihrem Unternehmen wäre es wert, nicht nur gefilmt, sondern als Raum und Zeitverlauf verstanden zu werden?
Sprechen Sie mit dem VISORIC Expertenteam aus München über Spatial Computing, digitale Zwillinge und XR-Training. Gemeinsam entwickeln wir aus Ihrem Ablauf einen präzisen, nachvollziehbaren nächsten Schritt.
Kontakt:
E-Mail: info@visoric.com
Telefon: +49 89 21552678
Quellen und Referenzen
- Vanni, Gasperini, Tombari, Plizzari. Topology-Aware 4D Gaussian Splatting for Egocentric Videos. arXiv:2611.16012, Preprint, 11. November 2026. Projektseite topoego.github.io.
- Grauman et al. Ego4D, Around the World in 3,000 Hours of Egocentric Video. CVPR 2022, arXiv:2110.07058.
- Damen et al. Scaling Egocentric Vision, The EPIC-KITCHENS Dataset. ECCV 2018, arXiv:1804.02748.
- Reconstructing 4D Spatial Intelligence, A Survey. arXiv:2507.21045, 2025.
- Schönberger und Frahm. Structure-from-Motion Revisited. CVPR 2016. COLMAP-Dokumentation, colmap.readthedocs.io.
- Carion et al. SAM 3, Segment Anything with Concepts. Meta, arXiv:2511.16719, November 2025, ICLR 2026.
- Zhang et al. EgoGaussian, Dynamic Scene Understanding from Egocentric Video with 3D Gaussian Splatting. arXiv:2406.19811, 3DV 2025.
- Kerbl, Kopanas, Leimkühler, Drettakis. 3D Gaussian Splatting for Real-Time Radiance Field Rendering. ACM Transactions on Graphics 42(4), 2023.
- Wu et al. 4D Gaussian Splatting for Real-Time Dynamic Scene Rendering. CVPR 2024.
- IEEE Technology Navigator. PSNR, Peak Signal-to-Noise Ratio, Überblick zu Definition und Grenzen. technav.ieee.org.
- Forasoft. PSNR explained, Definition, Formel und Wertebereiche. forasoft.com, Stand November 2026.
- Bringing a Personal Point of View, Evaluating Dynamic 3D Gaussian Splatting for Egocentric Scene Reconstruction. Unabhängige Nachprüfung, arXiv:2604.23803, 2026.
- Chavan. AI-based worker guidance in assembly and disassembly operations using multimodal ego/exo-centric data capture and structured task knowledge. Fraunhofer-Publica, 2026.
- Schoonbeek et al. IndustReal, Dataset of Egocentric Videos for Procedure Understanding. arXiv:2310.17323, 2023.
- VISORIC Praxisprojekte in den Bereichen Digitale Zwillinge, Echtzeit-3D und Spatial Computing.
- XR Stager Plattform für Echtzeit-3D, Digitale Zwillinge, Knowledge AI und industrielle Spatial-Computing-Anwendungen.
Kontaktieren Sie uns:
E-Mail: info@xrstager.com
Telefon: +49 89 21552678
Kontaktpersonen:
Ulrich Buckenlei (Kreativdirektor)
Mobil: +49 152 53532871
E-Mail: ulrich.buckenlei@xrstager.com
Nataliya Daniltseva (Projektleiterin)
Mobil: +49 176 72805705
E-Mail: nataliya.daniltseva@xrstager.com
Adresse:
VISORIC GmbH
Bayerstraße 13
D-80335 München